今天下午我研究了一个问题,RAG 这技术到底还有没有用。研究完去搜索引擎验证了一下,结论比我想的还干脆。这门技术已经是淘汰落后的产物,学得慢的人可以整段跳过,等你学完,它也过时了。
搜索引擎已经投完票了
先看证据。搜 RAG 系统,前排长这样。
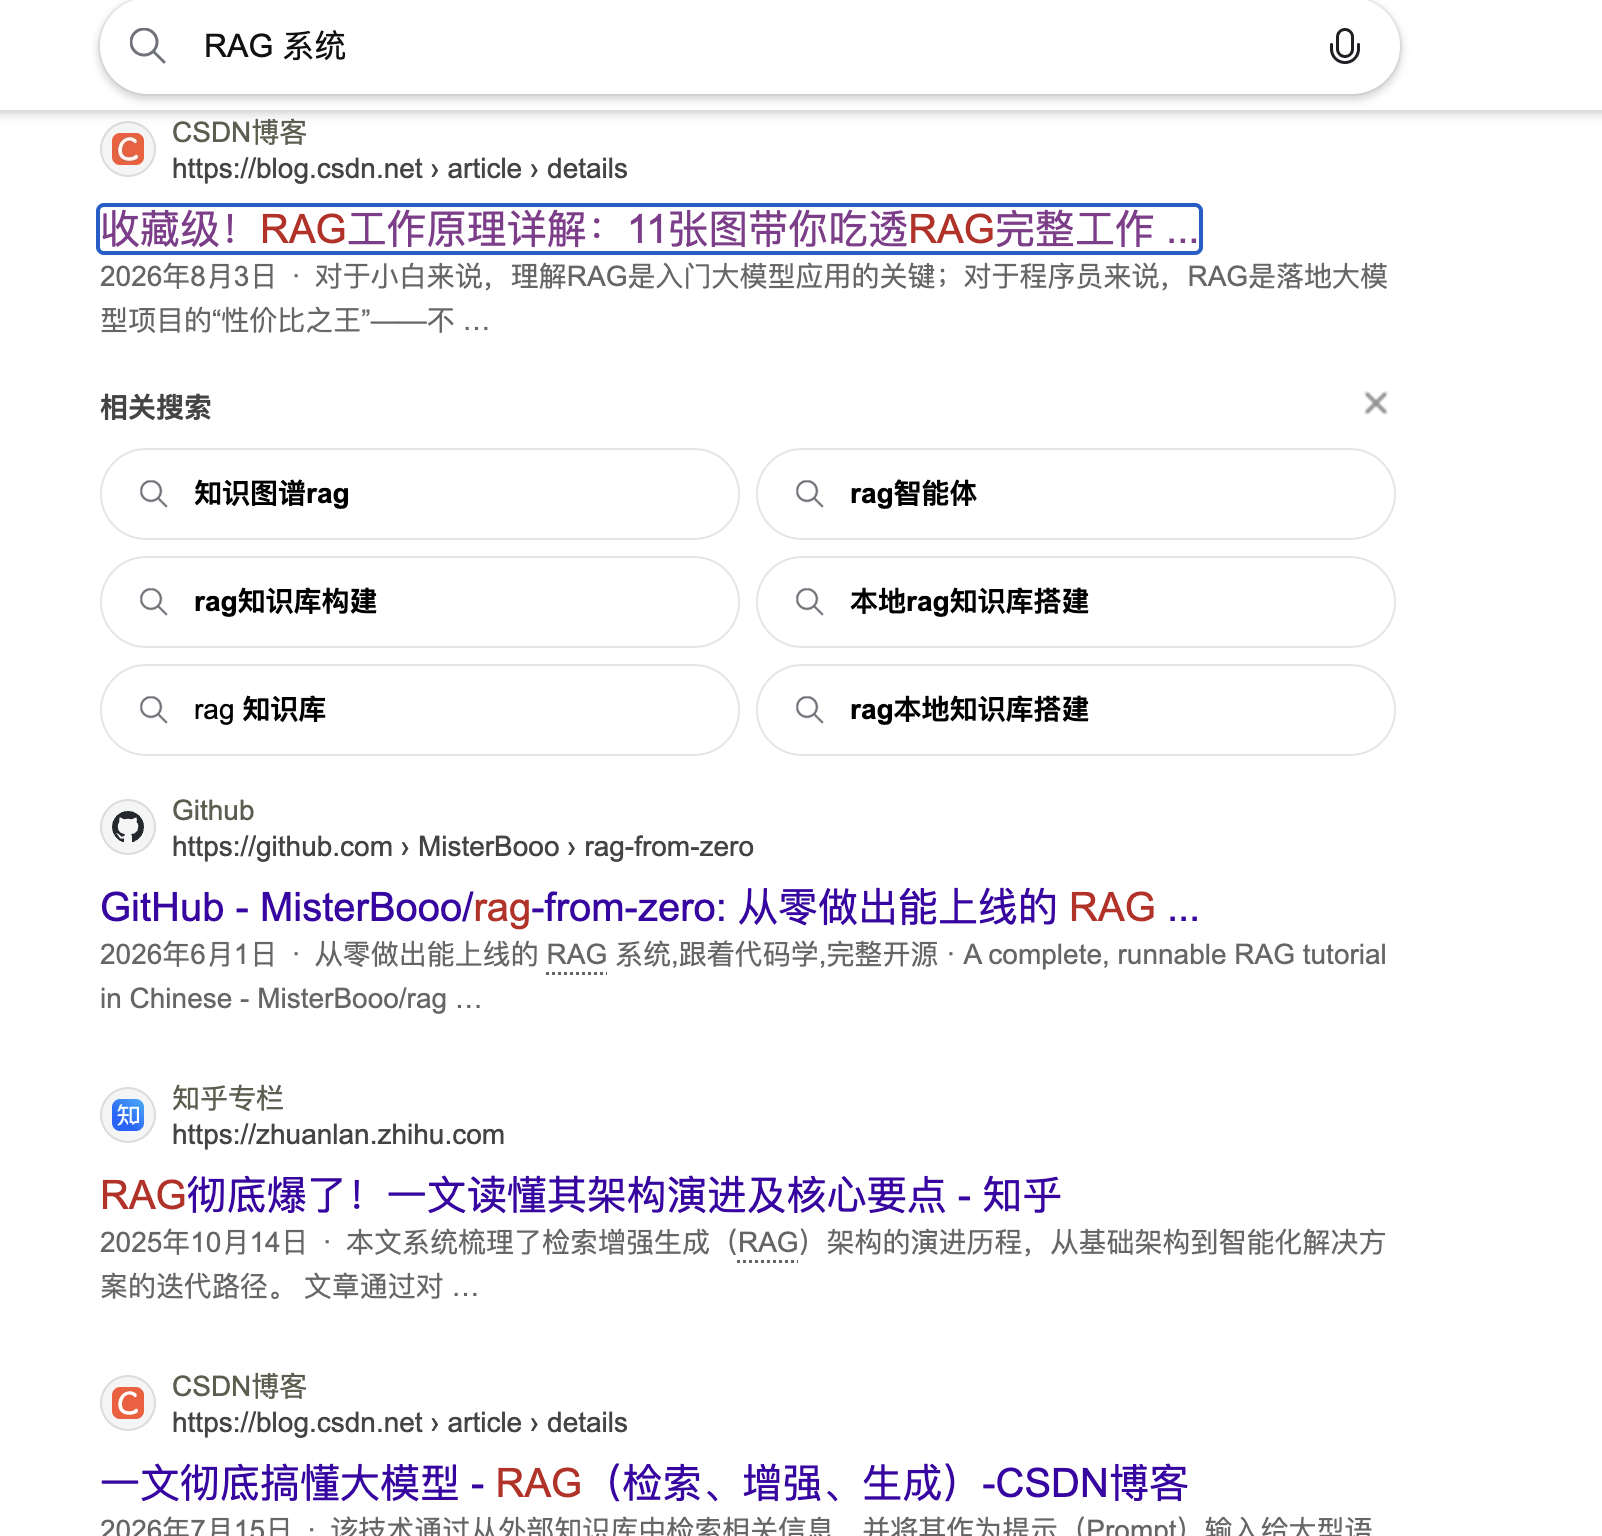
CSDN 的收藏级教程,知乎的彻底爆了,GitHub 的从零入门项目。标题一个比一个响,内容全是 2023 年那套流程的复读。切块,embedding,向量库,取 top 5,拼进 prompt。
再限定近一年,约 12.8 万条结果。
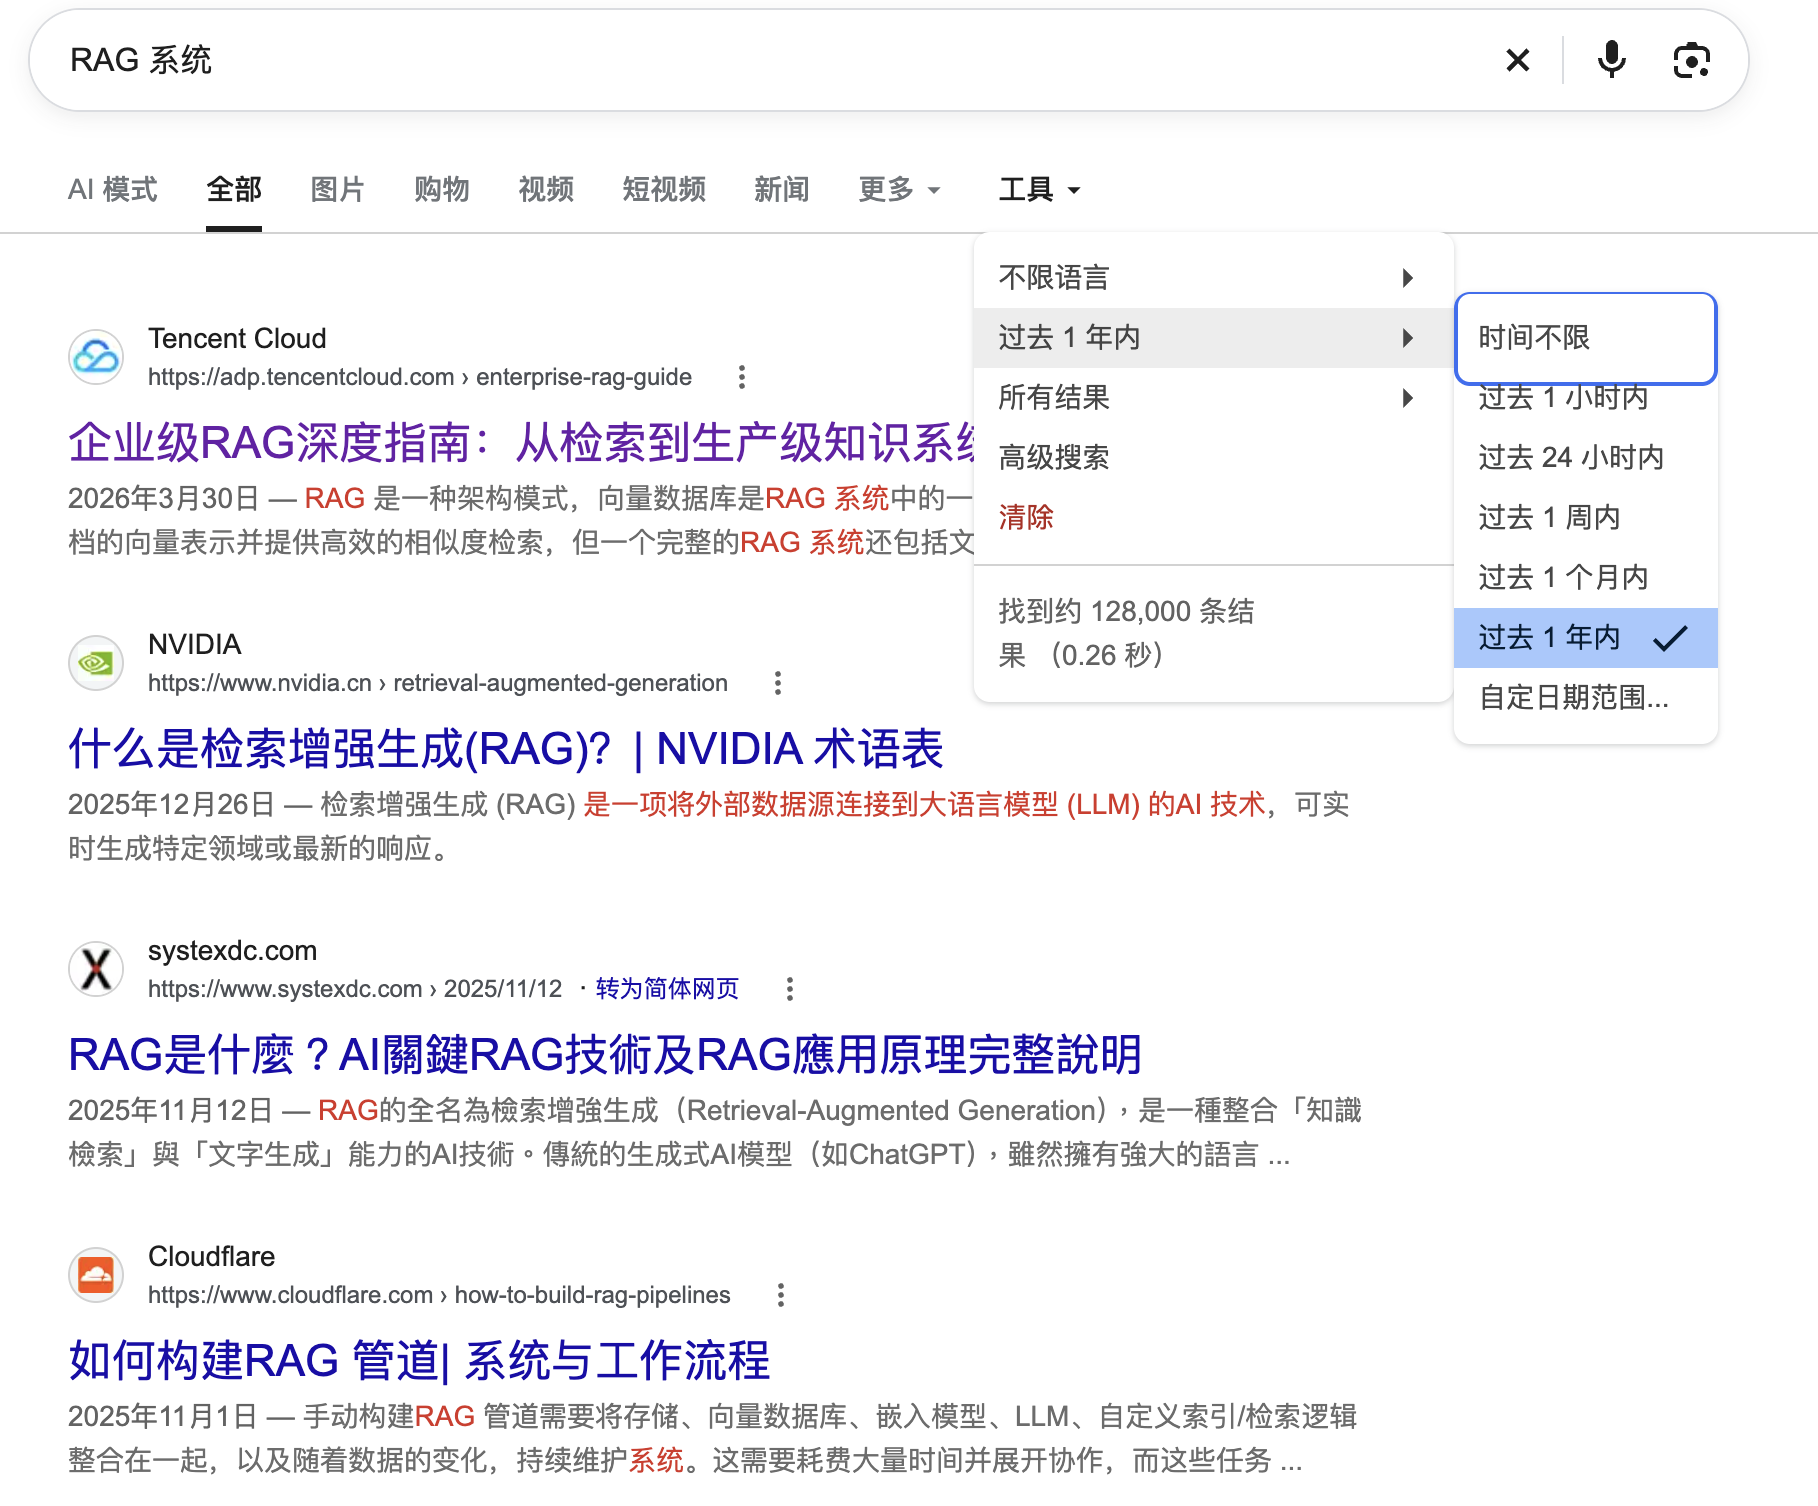
腾讯云的企业级 RAG 指南落地页,NVIDIA 的术语科普,繁体字厂商博客。点开看身份就很清楚,要么卖云,要么卖课,剩下的在给入门者解释什么是 RAG。没有一条来自一线 AI 团队的工程实践。
内容农场的嗅觉最灵。他们还守着这个关键词,说明读者里只剩入门的人和待割的韭菜。真正造 agent 的公司,工程博客里已经不写这个词。Anthropic 2025 年 9 月那篇讲 context engineering 的长文,通篇没出现 RAG 这三个字母,讲检索用的是按需加载,例子是 glob 和 grep。前线换了阵地,阵地上还插着旧旗子。
一线团队的说法
Anthropic 在 Building Effective Agents 里写得很直接。agentic 系统的基本单元,是一个增强过的 LLM。
The basic building block of agentic systems is an LLM enhanced with augmentations such as retrieval, tools, and memory
检索,工具,记忆,三样并列,检索只占其中一样。这三样怎么用,文章也说了。
Our current models can actively use these capabilities
自己生成搜索查询,自己挑工具,哪些信息要留下也自己定。这三件事,2023 年的 RAG 流水线全部替模型做了,理由是当年模型做不了。现在模型能做了,替它做决定的那一层就只剩一个功能,挡路。
替模型做决定的那个东西更逗。向量检索里,一条查询跟库里的文本块算相似度,谁排前面谁进 prompt,全由一个 embedding 模型定。花大价钱调来的大模型还没开口,材料已经被一个几亿参数的小模型筛完了。神经病才用 embedding 模型代替大模型思考。你的 embedding 模型,比大模型思考得还强吗?
这份活本质上就是关键词检索。用户的问题拆成关键词,拿关键词去搜,BM25 干了几十年,一个 rg 都能凑合。以前愁的是机器不会想关键词,才请 embedding 模型来猜语义。现在大模型自己就会想关键词,一个顶一个小模型。让大模型自己想关键词,不就行了。
最能打的 agent,检索不用向量库
Anthropic 自己的 Claude Code 就是个例子。还是那篇 context engineering 的文章,说它不给代码库建向量索引,靠 glob 和 grep 按需找文件,这样绕开了索引过期的问题。造最强 coding agent 的公司,自己都不给代码建向量库,你还在给代码库做 embedding。
数据问题更直接。过去 30 天哪个接口失败率最高,模型写一条 SQL 就出来了,向量库帮不上忙。全文检索,Elasticsearch 的 BM25 干了二十多年。连 OpenAI 的文件检索也是语义、关键词、重排一起上,没人敢只靠向量相似度。
向量检索还剩一块地盘,语义模糊的查询。它降级成了工具箱里的一把工具,跟 rg、SQL、Elasticsearch 摆在一起,模型自己挑着用。我想不出哪个场景,需要先建一条名叫 RAG 的流水线,把模型焊死在向量库上。
现代 RAG 的核心正在从“替模型决定怎么检索”,转变为“为 Agent 提供高质量、可调用、可组合的检索能力”。
考纲换了,名字也换了
context engineering 这个词是 2025 年 6 月底火起来的。Andrej Karpathy,前特斯拉 AI 总监,在 X 上发帖说 prompt engineering 这个词小看了这项工作,工业级 LLM 应用里真正的活是管好整个上下文窗口。
Context engineering is the delicate art and science of filling the context window with just the right information for the next step.
三个月后 Anthropic 发长文接住这个词,定义是,给模型挑出推理时最优的那批 token。管的东西包括系统提示词、工具、样例、记忆,还有长上下文的压缩和子 agent 拆分。检索在里面占一格。
长上下文把小场景也吃了。Anthropic 给过数字,20 万 token 以下的知识库整个塞进上下文就行,配 prompt cache 控制成本。切坏块、召不回这些老病直接消失。但窗口大不等于随便塞,同一篇文章提了 context rot,token 越多召回越差,窗口再大也得有人挑。
两头都指向同一件事。这一轮模型该看什么,需要一个统一的层来管。检索,工具,记忆,长上下文,一起管。这就是 Context Engineering,也是现在还在做 RAG 的人实际在玩的东西。名字换了,考纲换了,按 2023 年讲义复习的人,考不上了。
学得慢的,恭喜可以不学
具体动作就三条。把问题从怎么做 RAG,换成这一轮模型该看到什么。给模型接上搜索工具,接口别叫 rag(),叫 search()。把搜什么、搜几轮、够不够的决定权,交还给模型。
还在开课讲 RAG 的讲师可以想想,讲义里那条流水线是三年前写的。这三年模型换了多少代,讲义一页没动,学员交钱参观博物馆。
做系统的人也自查一下。模型开口之前,有没有一段代码在替它决定怎么检索。有的话,那段代码是遗产,越早删越好。
标题那句话我是认真的。这种迭代速度下,学得慢就是可以不学。省下的时间拿去看 Anthropic 的三篇工程文章,比任何 RAG 课都值。
脑子跟向量库一个道理。数据不更新,查出来的全是垃圾。
来源
- Anthropic, Building Effective Agents
- Anthropic, Effective Context Engineering for AI Agents
- Anthropic, Contextual Retrieval
- Andrej Karpathy, X 帖子, 2025-06-25,context engineering 一词由此流行
- OpenAI, Retrieval Guide